Tương lai của học sâu có thể bị phá vỡ thành 3 mô hình học tập này
Tương lai của học sâu có thể bị phá vỡ thành 3 mô hình học tập này
Học kết hợp, tổng hợp & rút gọn

Trang web gốc:
Học sâu là một lĩnh vực rộng lớn, xoay quanh một thuật toán mà hình dạng của nó được xác định bởi hàng triệu hoặc thậm chí hàng tỷ biến số và liên tục bị thay đổi - mạng nơ-ron. Có vẻ như mỗi ngày một số lượng lớn các phương pháp và kỹ thuật mới đang được đề xuất.
Tuy nhiên, nói chung, học sâu trong kỷ nguyên hiện đại có thể được chia thành ba mô hình học tập cơ bản. Trong mỗi cách đều có một cách tiếp cận và niềm tin hướng tới việc học mang lại tiềm năng đáng kể và sự quan tâm để tăng sức mạnh và phạm vi hiện tại của học sâu.
Học tập kết hợp - làm thế nào các phương pháp học sâu hiện đại có thể vượt qua ranh giới giữa học tập có giám sát và không giám sát để đáp ứng cho một lượng lớn dữ liệu chưa được gắn nhãn chưa được sử dụng?
Học tổng hợp - làm thế nào các mô hình hoặc thành phần khác nhau có thể được kết nối trong các phương pháp sáng tạo để tạo ra một mô hình tổng hợp lớn hơn tổng các phần của nó?
Giảm học - làm thế nào để có thể giảm cả kích thước và luồng thông tin của các mô hình, cho cả mục đích hiệu suất và triển khai, trong khi vẫn duy trì sức mạnh dự đoán bằng hoặc lớn hơn?
Tương lai của học sâu nằm trong ba mô hình học tập này, mỗi mô hình học được kết nối chặt chẽ với nhau.
Học tập kết hợp
Mô hình này tìm cách vượt qua ranh giới giữa học tập có giám sát và không giám sát. Nó thường được sử dụng trong bối cảnh kinh doanh vì thiếu và chi phí cao của dữ liệu được gắn nhãn. Về bản chất, học tập kết hợp là một câu trả lời cho câu hỏi,
Làm cách nào tôi có thể sử dụng các phương pháp được giám sát để giải quyết / kết hợp với các vấn đề không được giám sát?
Thứ nhất, học bán giám sát đang có chỗ đứng trong cộng đồng học máy vì có thể thực hiện đặc biệt tốt các vấn đề được giám sát với ít dữ liệu được gắn nhãn. Ví dụ: GAN bán giám sát được thiết kế tốt (Mạng đối thủ chung) đã đạt được độ chính xác trên 90% trên tập dữ liệu MNIST sau khi xem chỉ có 25 ví dụ đào tạo.
Học bán giám sát được thiết kế cho các bộ dữ liệu trong đó có nhiều dữ liệu không được giám sát nhưng lượng dữ liệu được giám sát nhỏ. Trong khi theo truyền thống, mô hình học tập có giám sát sẽ được đào tạo trên một phần của dữ liệu và mô hình không được giám sát kia, thì mô hình bán giám sát có thể kết hợp dữ liệu được gắn nhãn với thông tin chi tiết được trích xuất từ dữ liệu không được gắn nhãn.
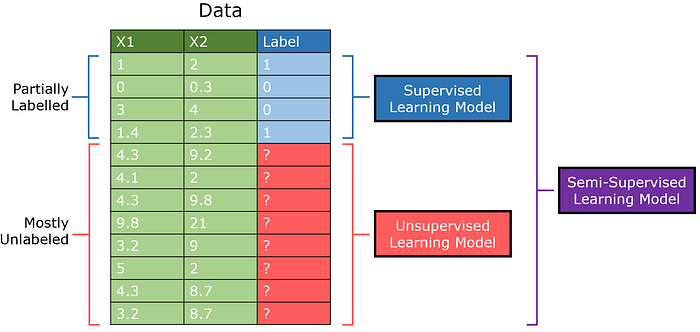
GAN bán giám sát (viết tắt là SGAN), là sự điều chỉnh của tiêu chuẩn Mô hình mạng đối thủ chung. Bộ phân biệt cả hai kết quả là 0/1 để cho biết một hình ảnh có được tạo hay không, nhưng cũng xuất ra lớp của mục (học đa đầu ra).
Điều này dựa trên ý tưởng rằng thông qua bộ phân biệt học cách phân biệt giữa hình ảnh thực và hình ảnh được tạo, nó có thể tìm hiểu cấu trúc của chúng mà không cần nhãn cụ thể. Với sự củng cố bổ sung từ một lượng nhỏ dữ liệu được gắn nhãn, các mô hình bán giám sát có thể đạt được hiệu suất cao nhất với lượng dữ liệu được giám sát tối thiểu.
Bạn có thể đọc thêm về SGAN và học tập bán giám sát nơi đây.
GAN cũng tham gia vào một lĩnh vực học tập kết hợp khác - tự giám sát học tập, trong đó các vấn đề không được giám sát được đóng khung rõ ràng là những vấn đề được giám sát. GAN tạo dữ liệu được giám sát một cách giả tạo thông qua việc giới thiệu bộ tạo; nhãn được tạo ra để xác định hình ảnh thực / được tạo. Từ tiền đề không được giám sát, một nhiệm vụ có giám sát đã được tạo.
Ngoài ra, hãy xem xét việc sử dụng mô hình mã hóa-giải mã để nén. Ở dạng đơn giản nhất, chúng là mạng nơ-ron với một lượng nhỏ các nút ở giữa để thể hiện một số dạng nút cổ chai, dạng nén. Hai phần ở hai bên là bộ mã hóa và bộ giải mã.
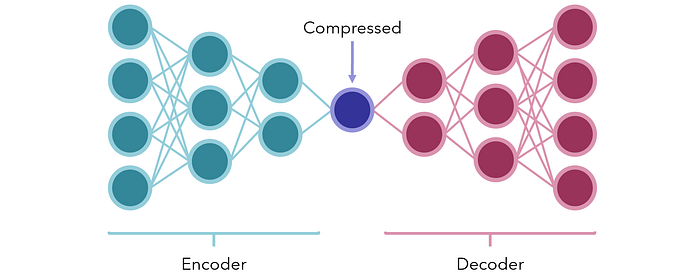
Mạng được đào tạo để tạo ra giống nhau đầu ra dưới dạng đầu vào vectơ (một tác vụ được giám sát được tạo nhân tạo từ dữ liệu không được giám sát). Bởi vì có một nút thắt cổ chai được cố ý đặt ở giữa, mạng không thể truyền thông tin một cách thụ động; thay vào đó, nó phải tìm ra những cách tốt nhất để bảo toàn nội dung của đầu vào thành một đơn vị nhỏ để nó có thể được giải mã lại một cách hợp lý bởi bộ giải mã.
Sau khi được đào tạo, bộ mã hóa và bộ giải mã được tách rời và có thể được sử dụng trên các đầu nhận của dữ liệu nén hoặc mã hóa để truyền thông tin ở dạng cực nhỏ với ít hoặc không có dữ liệu bị mất. Chúng cũng có thể được sử dụng để giảm kích thước của dữ liệu.
Một ví dụ khác, hãy xem xét một bộ sưu tập lớn các văn bản (có thể là các bình luận từ một nền tảng kỹ thuật số). Thông qua một số cụm hoặc học tập đa dạng , chúng ta có thể tạo các nhãn cụm cho các bộ sưu tập văn bản, sau đó coi chúng như các nhãn (miễn là việc phân nhóm được thực hiện tốt).
Sau khi mỗi cụm được diễn giải (ví dụ: cụm A biểu thị các nhận xét phàn nàn về sản phẩm, cụm B biểu thị phản hồi tích cực, v.v.), một kiến trúc NLP sâu sắc như BERT sau đó có thể được sử dụng để phân loại văn bản mới thành các cụm này, tất cả đều có dữ liệu hoàn toàn không được gắn nhãn và sự tham gia của con người tối thiểu.
Đây lại là một ứng dụng hấp dẫn trong việc chuyển đổi các tác vụ không được giám sát thành các tác vụ được giám sát. Trong thời đại mà phần lớn dữ liệu là dữ liệu không được giám sát, có giá trị và tiềm năng to lớn trong việc xây dựng cầu nối sáng tạo để vượt qua ranh giới giữa học tập có giám sát và không giám sát với học tập kết hợp.
Học tổng hợp
Học tổng hợp tìm cách sử dụng kiến thức không phải của một mô hình mà của nhiều mô hình. Đó là niềm tin rằng thông qua sự kết hợp độc đáo hoặc tiêm thông tin - cả tĩnh và động - học sâu có thể liên tục hiểu sâu hơn và hiệu quả hơn so với một mô hình duy nhất.
Học chuyển giao là một ví dụ rõ ràng về học tổng hợp và được tạo tiền đề dựa trên ý tưởng rằng trọng số của một mô hình có thể được mượn từ một mô hình được đào tạo trước cho một nhiệm vụ tương tự, sau đó được tinh chỉnh cho một nhiệm vụ cụ thể. Các mô hình định sẵn như Khởi đầu hoặc VGG-16 được xây dựng với các kiến trúc và trọng lượng được thiết kế để phân biệt giữa một số lớp hình ảnh khác nhau.
Nếu tôi định đào tạo một mạng nơ-ron để nhận biết động vật (mèo, chó, v.v.), tôi sẽ không đào tạo một mạng nơ-ron phức tạp từ đầu vì sẽ mất quá nhiều thời gian để đạt được kết quả tốt. Thay vào đó, tôi sẽ lấy một mô hình được đào tạo trước như Inception, mô hình này đã lưu trữ những điều cơ bản về nhận dạng hình ảnh và đào tạo thêm một vài kỷ nguyên trên tập dữ liệu.
Tương tự, nhúng từ trong mạng nơ-ron NLP, ánh xạ các từ gần hơn về mặt vật lý với các từ khác trong một không gian nhúng tùy thuộc vào mối quan hệ của chúng (ví dụ: "apple" và "orange" có khoảng cách nhỏ hơn so với "apple" và "truck"). Các bản nhúng trước như GloVe có thể được đặt vào mạng nơ-ron để bắt đầu từ những gì đã là một ánh xạ hiệu quả của các từ đến các thực thể số, có ý nghĩa.
Ít rõ ràng hơn, cạnh tranh cũng có thể kích thích sự phát triển kiến thức. Thứ nhất, Mạng đối thủ chung vay mượn từ mô hình học tập tổng hợp bằng cách đặt hai mạng nơ-ron vào nhau về cơ bản. Mục tiêu của người tạo là đánh lừa người phân biệt và mục tiêu của người phân biệt là không bị lừa.
Sự cạnh tranh giữa các mô hình sẽ được gọi là 'học theo đối thủ', không nên nhầm lẫn với một loại học theo đối thủ khác đề cập đến thiết kế các đầu vào độc hại và khai thác các ranh giới quyết định yếu trong các mô hình.
Học tập theo đối phương có thể kích thích các mô hình, thường là các loại khác nhau, trong đó hiệu suất của một mô hình có thể được thể hiện trong mối quan hệ với hiệu suất của những người khác. Vẫn còn rất nhiều nghiên cứu cần được thực hiện trong lĩnh vực học đối nghịch, với mạng đối thủ chung là sự sáng tạo nổi bật duy nhất của trường con.
Mặt khác, học tập cạnh tranh tương tự như học tập theo phương thức đối nghịch, nhưng được thực hiện trên quy mô từng nút: các nút cạnh tranh để giành quyền phản hồi với một tập hợp con của dữ liệu đầu vào. Học tập cạnh tranh được thực hiện trong một 'lớp cạnh tranh', trong đó một tập hợp các tế bào thần kinh đều giống nhau, ngoại trừ một số trọng số được phân phối ngẫu nhiên.
Mỗi vectơ trọng số của mỗi nơ-ron được so sánh với vectơ đầu vào và nơ-ron có độ tương đồng cao nhất, nơ-ron 'người chiến thắng lấy tất cả', được kích hoạt (đầu ra = 1). Những cái khác bị 'vô hiệu hóa' (đầu ra = 0). Kỹ thuật không giám sát này là thành phần cốt lõi của bản đồ tự tổ chức và khám phá tính năng.
Một ví dụ thú vị khác về cách học tổng hợp là trong tìm kiếm kiến trúc thần kinh. Nói một cách đơn giản, mạng nơ-ron (thường là lặp lại) trong môi trường học tăng cường học cách tạo ra mạng nơ-ron tốt nhất cho tập dữ liệu - thuật toán tìm ra kiến trúc tốt nhất cho bạn! Bạn có thể đọc thêm về lý thuyết nơi đây và triển khai bằng Python nơi đây.
Phương pháp tổng hợp cũng là một yếu tố cơ bản trong học tập tổng hợp. Các phương pháp kết hợp sâu đã được chứng minh là rất có hiệu lựcvà việc xếp chồng các mô hình end-to-end, như bộ mã hóa và bộ giải mã, đã trở nên phổ biến.
Phần lớn việc học tổng hợp là tìm ra những cách độc đáo để xây dựng kết nối giữa các mô hình khác nhau. Nó được hình thành dựa trên ý tưởng rằng,
Một mô hình đơn lẻ, thậm chí là một mô hình rất lớn, hoạt động kém hơn một số mô hình / thành phần nhỏ, mỗi mô hình được ủy nhiệm chuyên môn hóa một phần nhiệm vụ.
Ví dụ, hãy xem xét nhiệm vụ xây dựng một chatbot cho một nhà hàng.

Chúng ta có thể phân đoạn nó thành ba phần riêng biệt: easyries / chit-chat, truy xuất thông tin và một hành động, đồng thời thiết kế một mô hình để chuyên môn hóa từng phần. Ngoài ra, chúng ta có thể ủy thác một mô hình số ít để thực hiện cả ba tác vụ.
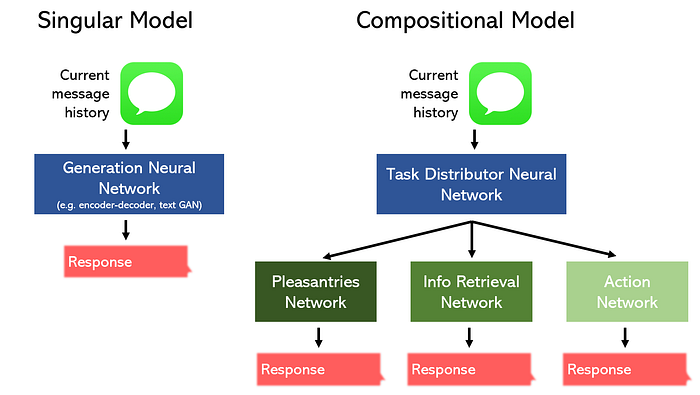
Không có gì ngạc nhiên khi mô hình tổng hợp có thể hoạt động tốt hơn trong khi chiếm ít không gian hơn. Ngoài ra, các loại cấu trúc liên kết phi tuyến này có thể dễ dàng được xây dựng bằng các công cụ như API chức năng của Keras.
Để xử lý sự đa dạng ngày càng tăng của các loại dữ liệu, như video và dữ liệu 3 chiều, các nhà nghiên cứu phải xây dựng các mô hình tổng hợp sáng tạo
Đọc thêm về học tập thành phần và tương lai nơi đây.
Giảm học
Quy mô của các mô hình, đặc biệt là trong NLP - trung tâm của sự phấn khích bùng nổ trong nghiên cứu học sâu - ngày càng tăng, bởi rất nhiều. Mẫu GPT-3 gần đây nhất có 175 tỷ thông số. So sánh nó với BERT giống như so sánh Sao Mộc với một con muỗi (tốt, không phải theo nghĩa đen). Tương lai của học sâu có lớn hơn không?
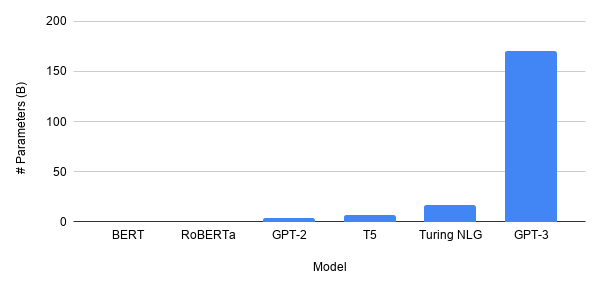
Rất có thể cho là không. Phải thừa nhận rằng GPT-3 rất mạnh mẽ, nhưng trước đây nó đã nhiều lần chứng tỏ rằng 'khoa học thành công' là những ngành có tác động lớn nhất đến nhân loại. Bất cứ khi nào học thuật đi quá xa so với thực tế, nó thường trở nên mờ mịt. Đó là trường hợp khi mạng nơ-ron bị lãng quên vào cuối những năm 1900 trong một khoảng thời gian ngắn vì có quá ít dữ liệu có sẵn nên ý tưởng dù tài tình đến mấy cũng trở nên vô dụng.
GPT-3 là một mô hình ngôn ngữ khác và nó có thể viết văn bản thuyết phục. Các ứng dụng của nó ở đâu? Có, chẳng hạn, nó có thể tạo ra các câu trả lời cho một truy vấn. Tuy nhiên, có những cách hiệu quả hơn để thực hiện việc này (ví dụ: xem qua một biểu đồ tri thức và sử dụng một mô hình nhỏ hơn như BERT để đưa ra câu trả lời).
Chỉ đơn giản là có vẻ như không phải là trường hợp kích thước khổng lồ của GPT-3, chưa kể đến một mô hình lớn hơn, là khả thi hoặc cần thiết nếu làm khô của sức mạnh tính toán.
“Định luật Moore sắp cạn kiệt.”
- Satya Nadella, Giám đốc điều hành của Microsoft
Thay vào đó, chúng tôi đang hướng tới một thế giới được nhúng AI, nơi một chiếc tủ lạnh thông minh có thể tự động đặt hàng tạp hóa và máy bay không người lái có thể tự điều hướng toàn bộ thành phố. Các phương pháp học máy mạnh mẽ có thể được tải xuống PC, điện thoại di động và chip nhỏ.
Điều này yêu cầu AI nhẹ: làm cho mạng nơ-ron nhỏ hơn trong khi vẫn duy trì hiệu suất.
Nó chỉ ra rằng, trực tiếp hoặc gián tiếp, hầu hết mọi thứ trong nghiên cứu học sâu đều phải làm với việc giảm lượng thông số cần thiết, điều này đi đôi với việc cải thiện khả năng tổng quát hóa và do đó, hiệu suất. Ví dụ, sự ra đời của các lớp chập đã làm giảm đáng kể số lượng các tham số cần thiết cho các mạng nơ-ron để xử lý hình ảnh. Các lớp lặp lại kết hợp ý tưởng về thời gian trong khi sử dụng cùng trọng số, cho phép mạng nơ-ron xử lý trình tự tốt hơn và với ít tham số hơn.
Nhúng các lớp ánh xạ rõ ràng các thực thể thành các giá trị số có ý nghĩa vật lý để không đặt gánh nặng lên các tham số bổ sung. Trong một cách diễn giải, Rơi ra ngoài các lớp chặn rõ ràng các tham số hoạt động trên các phần nhất định của đầu vào. Chính quy hóa L1 / L2 đảm bảo mạng sử dụng tất cả các tham số của nó bằng cách đảm bảo không có tham số nào phát triển quá lớn và từng tham số tối đa hóa giá trị thông tin của chúng.
Với việc tạo ra các lớp chuyên biệt, các mạng ngày càng yêu cầu ít tham số hơn cho các dữ liệu phức tạp hơn và lớn hơn. Các phương pháp khác gần đây hơn tìm cách nén mạng một cách rõ ràng.
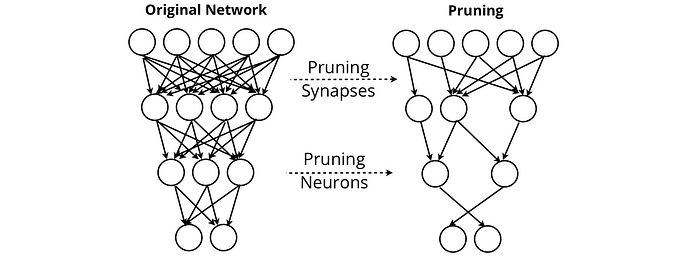
Tỉa mạng nơron tìm cách loại bỏ các khớp thần kinh và tế bào thần kinh không cung cấp giá trị cho đầu ra của mạng. Thông qua việc cắt tỉa, các mạng có thể duy trì hiệu suất của chúng trong khi loại bỏ gần như tất cả chính nó.
Các phương pháp khác như Chưng cất kiến thức bệnh nhân tìm các phương pháp để nén các mô hình ngôn ngữ lớn thành các biểu mẫu có thể tải xuống, chẳng hạn như điện thoại của người dùng. Đây là một cân nhắc cần thiết cho Hệ thống dịch máy thần kinh của Google (GNMT), hỗ trợ Google Dịch, cần thiết để tạo ra một dịch vụ dịch hiệu suất cao có thể được truy cập ngoại tuyến.
Về bản chất, giảm các trung tâm học tập xung quanh thiết kế tập trung vào triển khai. Đây là lý do tại sao hầu hết các nghiên cứu về giảm học tập đều đến từ bộ phận nghiên cứu của các công ty. Một khía cạnh của thiết kế tập trung vào triển khai là không tuân theo các số liệu hiệu suất một cách mù quáng trên tập dữ liệu, mà tập trung vào các vấn đề tiềm ẩn khi một mô hình được triển khai.
Ví dụ, đã đề cập trước đây đầu vào đối nghịch là các đầu vào độc hại được thiết kế để lừa mạng. Phun sơn hoặc dán trên biển báo có thể đánh lừa xe ô tô tự lái tăng tốc vượt quá tốc độ cho phép. Một phần của việc giảm thiểu học tập có trách nhiệm không chỉ là làm cho các mô hình đủ nhẹ để sử dụng, mà còn đảm bảo rằng nó có thể đáp ứng cho các trường hợp góc không được thể hiện trong bộ dữ liệu.
Giảm học có lẽ ít được chú ý nhất trong nghiên cứu về học sâu, bởi vì “chúng tôi đã cố gắng đạt được hiệu suất tốt với kích thước kiến trúc khả thi” gần như không hấp dẫn bằng “chúng tôi đạt được hiệu suất hiện đại với kiến trúc bao gồm của kajillions của các tham số ”.
Không thể tránh khỏi, khi việc theo đuổi cường điệu một tỷ lệ phần trăm cao hơn sẽ biến mất, như lịch sử đổi mới đã thể hiện, việc giảm học - vốn thực sự chỉ là học thực tế - sẽ nhận được nhiều sự chú ý hơn đáng có.
Bản tóm tắt
Học tập kết hợp tìm cách vượt qua ranh giới của học tập có giám sát và không giám sát. Các phương pháp như học tập bán giám sát và tự giám sát có thể trích xuất thông tin chi tiết có giá trị từ dữ liệu không được gắn nhãn, một điều gì đó cực kỳ có giá trị khi lượng dữ liệu không được giám sát tăng lên theo cấp số nhân.
Khi các nhiệm vụ ngày càng phức tạp, việc học tổng hợp sẽ giải cấu trúc một nhiệm vụ thành một số thành phần đơn giản hơn. Khi các thành phần này hoạt động cùng nhau - hoặc chống lại nhau - kết quả là một mô hình mạnh mẽ hơn.
Học giảm thiểu không nhận được nhiều sự quan tâm khi học sâu trải qua giai đoạn cường điệu, nhưng sẽ sớm xuất hiện đủ tính thực tiễn và thiết kế tập trung vào triển khai.
Cảm ơn vì đã đọc!
Tuyên bố: chỉ để trao đổi học thuật. Bản quyền của bài viết này thuộc về tác giả gốc. Nếu có gì sai, xin vui lòng liên hệ để xóa.